从推理到创造概念:通往 AI4Research 的三层智能
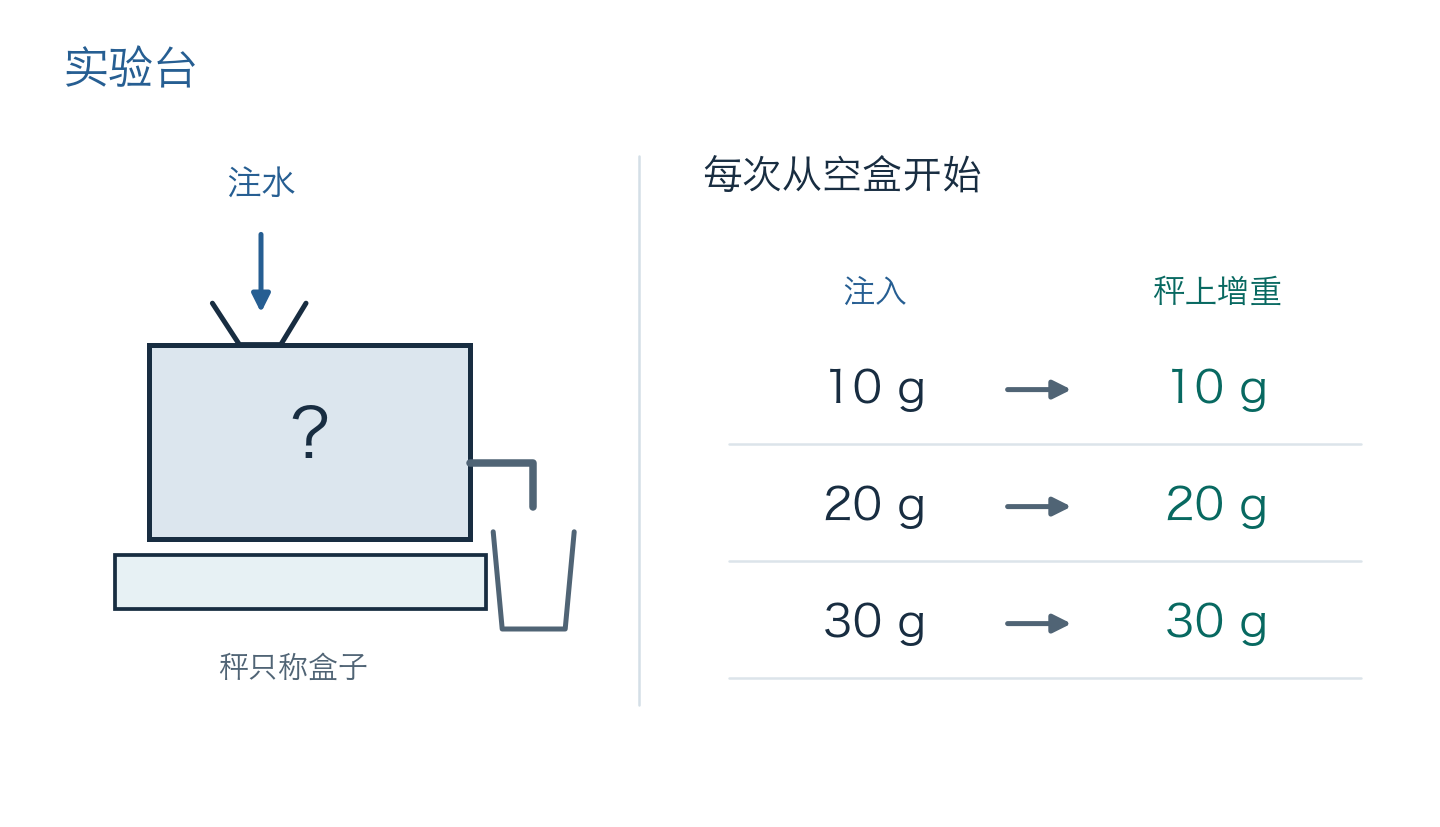
一只不透明的盒子放在电子秤上,侧管通向秤外的杯子。你可以往盒子里注水,却看不见内部。每次把盒子排空,分别注入 10、20、30 克水,秤恰好增重 10、20、30 克。现在只够再做一次实验。你会再注入 20 克,还是试试 50 克?
再注入 20 克
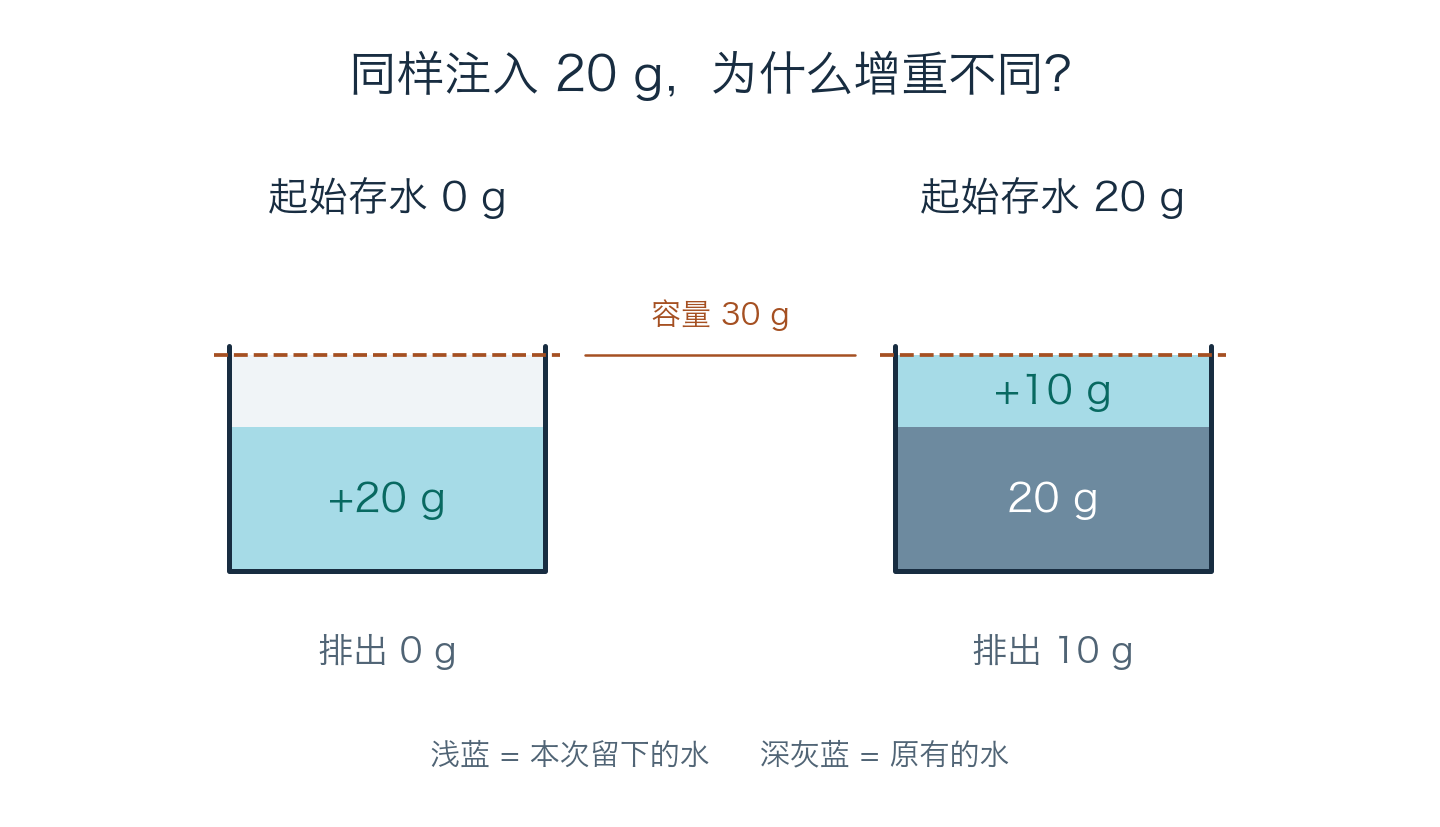
秤又增加了 20 克。这次重复增强了你对读数的信心。可如果同事猜盒子最多存 30 克,你俩还是会对这个结果点头。
改为注入 50 克
秤只增加了 30 克,秤外的杯子接到了另外 20 克。如果你押了 50 克,已经知道“注入多少就留下多少”在哪个条件下会失手。如果你押了 30 克,接下来还有个难题:盒子是每次最多留下 30 克,还是总共只能存 30 克?
把这份记录交给 AI,可以看出三种能力的区别。已知空盒能装 30 克,算出倒入 50 克后会留下多少,是推理。想区分“每次最多留 30 克”和“总共只能装 30 克”,可以连续倒两次 20 克,中间不排空。前一个假设预测第二次仍会增重 20 克,后一个预测只增重 10 克。用实验在两种解释之间做判断,是溯因。如果两次实测分别增重 20 克和 10 克,就可以用一个新的变量统一描述它们:每次注水前还剩多少容量。找出这个能用于预测下一次读数的变量,是抽象发现。
推理、溯因与抽象
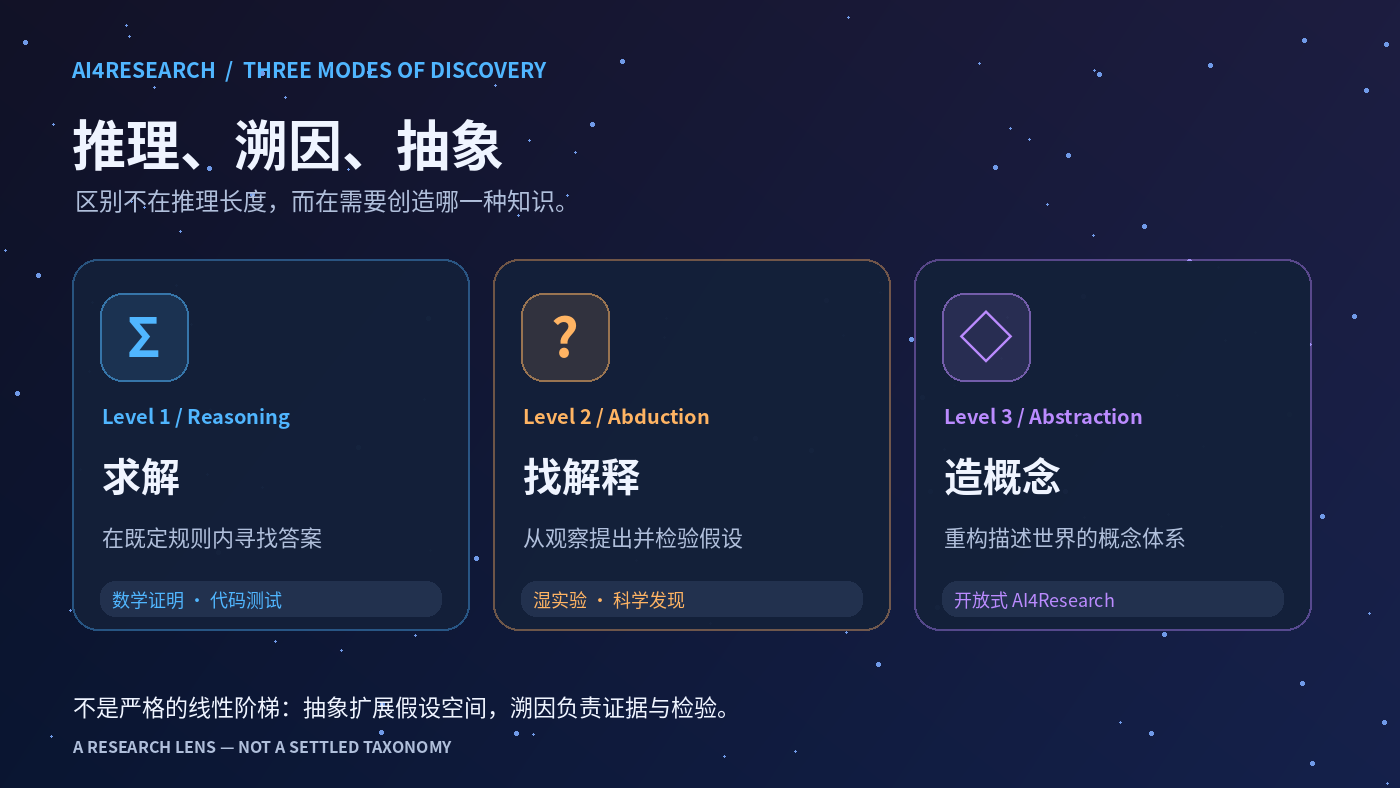
在哲学上,这三种能力处理的是不同的问题。推理(Reasoning)在本文主要指从给定前提推出结论。溯因(Abduction)从已知结果出发,提出一个可能使结果得到解释的假设。抽象(Abstraction)从具体经验中提取可以跨情境使用的概念或关系。
亚里士多德在《前分析篇》中系统讨论了演绎,强调结论如何从前提必然得出。皮尔士(Charles S. Peirce)在 1878 年把演绎、归纳和假设性推理区分开来,并在后来的工作中用“溯因”讨论我们如何为意外的观测提出解释。 [22] [1] [2]
抽象有另一条思想线索。洛克(John Locke)讨论了人如何从个别经验形成一般观念。认知科学家 Gentner 在类比研究中提出结构映射理论,指出对象之间的关系可以从一个领域迁移到另一个领域。在 AI 研究中,Chollet 则主张用系统从有限经验中习得新技能的效率来衡量智能。 [23] [3] [4]
Tom Zahavy 也沿用皮尔士对演绎、归纳和溯因的区分来讨论 AI 科学发现,尤其强调提出新假设这一步。在本文的框架里,我把演绎放在推理之下,并把归纳理解为抽象的一种形式。人在多个实例中辨认出共同规律,并把它推广到尚未见过的情形,已经在做抽象。 [24]
我把「抽象」进一步扩展到发现和修订概念本身。给定一组变量,AI 可以从观测中归纳出变量之间的关系。当同一个规律换个环境就失效时,AI 还可以重新考虑哪些变量值得保留、哪些需要引入,以及怎样用一套概念来描述不同环境。这样的抽象给下一轮溯因提供了新的候选解释。
推理的突破:可验证反馈如何支持数学发现
竞赛编程、奥数和研究数学接连取得进展,背后有一个共同条件:寻找解法很难,但一旦写出候选解,就有办法检查它。程序可以运行测试,几何构造可以交给符号系统推演,证明可以接受数学家审查或用形式系统核验。这些判据让系统有理由保留某条路径、放弃另一条路径。 [6] [20] [21] [15]
由此发展出几条彼此呼应的路线。用可核验答案训练,能让模型更常选中有效的解题策略;让学习到的策略引导符号搜索,能在大量合法推导中找到有用的中间步骤;在推理时增加计算,则给系统留下回溯和尝试其他构造的余地。这些路线已经从竞赛解题延伸到为开放问题给出可检查的论证。它们共同说明,验证条件足够清楚时,额外算力可以用于探索真正不同的解法,搜索所得也可以积累成更好的策略。 [6] [20] [21] [15]
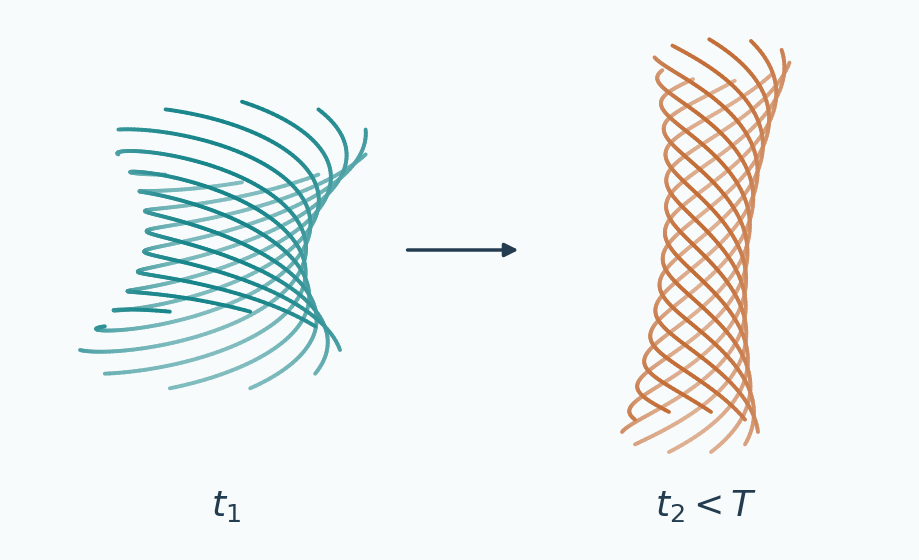 NS 方程 · 构造奇性解
涡核收缩并拉长。OpenAI 报告,在光滑外力作用下,其构造的三维流动可在有限时间内形成奇性。
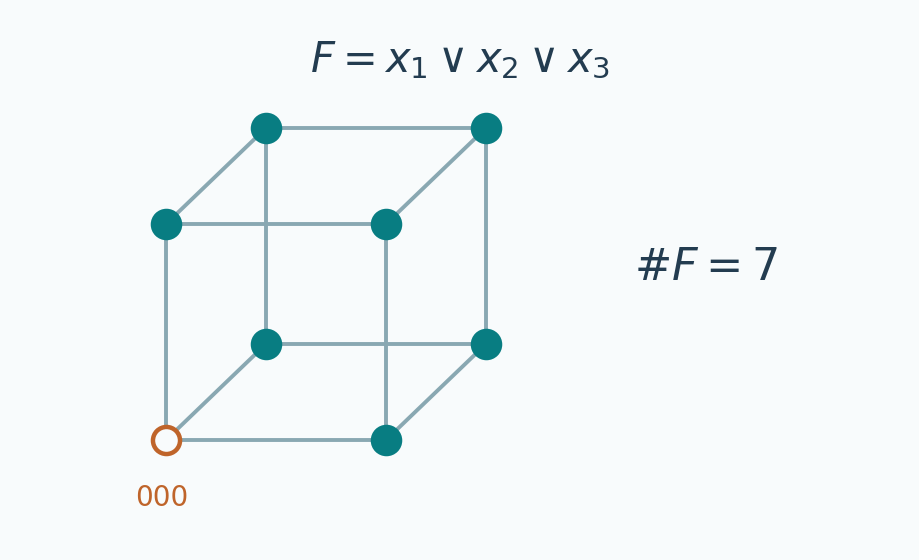 指数时间假设 · 证明算法上界
每个顶点是一种赋值。OpenAI 报告,对固定子句宽度,可在关于变量数的次指数时间内精确计数满足赋值。
溯因的前沿:从提出解释到用实验淘汰解释
实验科学多了一层困难。从两个假设出发,系统可以把推理都做对,却仍然不知道该相信哪一个。两者如果都能解释已有观测,最有用的下一步推导,就是找出它们会在哪个新条件下给出不同预测。到这里,解题能力才真正开始为溯因服务。
从生物医学假设生成、自动化计算实验到认知理论发现,已经出现三种相互衔接的进展:系统能综合文献提出可测试的候选,能运行实验比较候选的预测,也开始能依据新收集的数据修订解释。在不同研究中,候选干预得到了实验支持,修订后的理论也对留出数据作出了更好的预测。这些结果的共同意义在于,模型提出的解释已经可以接受独立证据的筛选,证据还可以改变下一轮提出的解释。 [7] [14] [17]
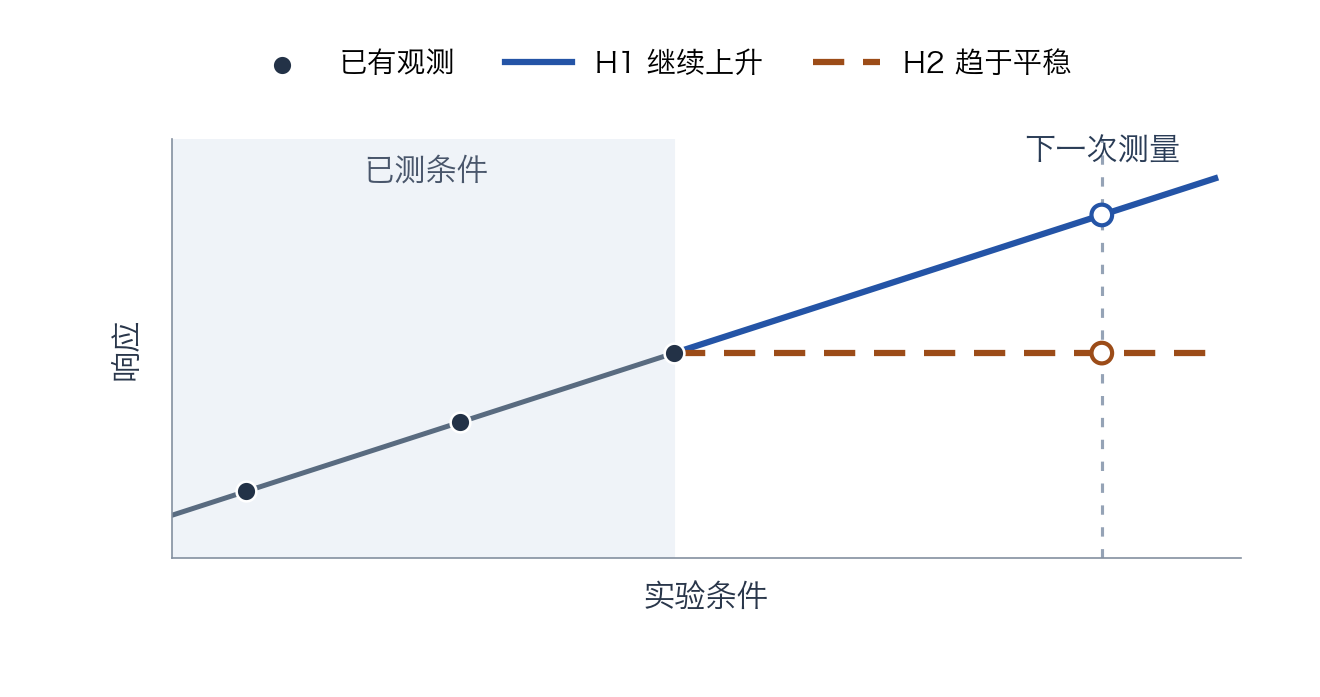
瓶颈也由此可见。提出另一个假设的成本很低,得到一条能区分假设的观测却可能很贵。文献还会选择性地保留阳性结果,使模型更容易读到胜出的解释,难以重建被淘汰的理由。用贝叶斯实验设计的语言,给定当前数据 D 与候选假设 H,等成本时应优先选择使 I(H; Yₐ ∣ D) 最大的实验 a,其中 Yₐ 是尚未知晓的结果。所有候选都预期的随机波动,即使难以预测,也提供不了区分它们的信息。 [8] [11]
抽象与 AGI:跨环境迁移和持续学习需要什么
用信息增益选择实验时,我们衡量的是这次实验能在多大程度上区分当前的候选假设。如果所有候选都忽略同一个状态变量,实验可能非常有效地选出了其中最好的模型,而它们仍在相同条件下系统性失手。这时,继续扩大候选数量的价值取决于新候选能否表达原来写不出的区别。问题由此从“哪种解释更可信”推进到“我们用什么概念来构造解释”。
我认为,AGI 需要抽象,理由来自通用性本身。一个系统一生只能获得有限经验,却要适应训练时无法穷举的任务组合。它必须判断哪些情境可以共享知识,哪些表面相似的情境需要不同的预测或行动。把观测历史 X 映射为状态 Z = φ(X),就是在作这个判断。好的抽象允许外观相异的经验共同训练一种能力,同时保留对后果真正重要的区别。它可以存在于模型学到的表征中,也可以成为人能命名的新概念。 [3] [4] [13]
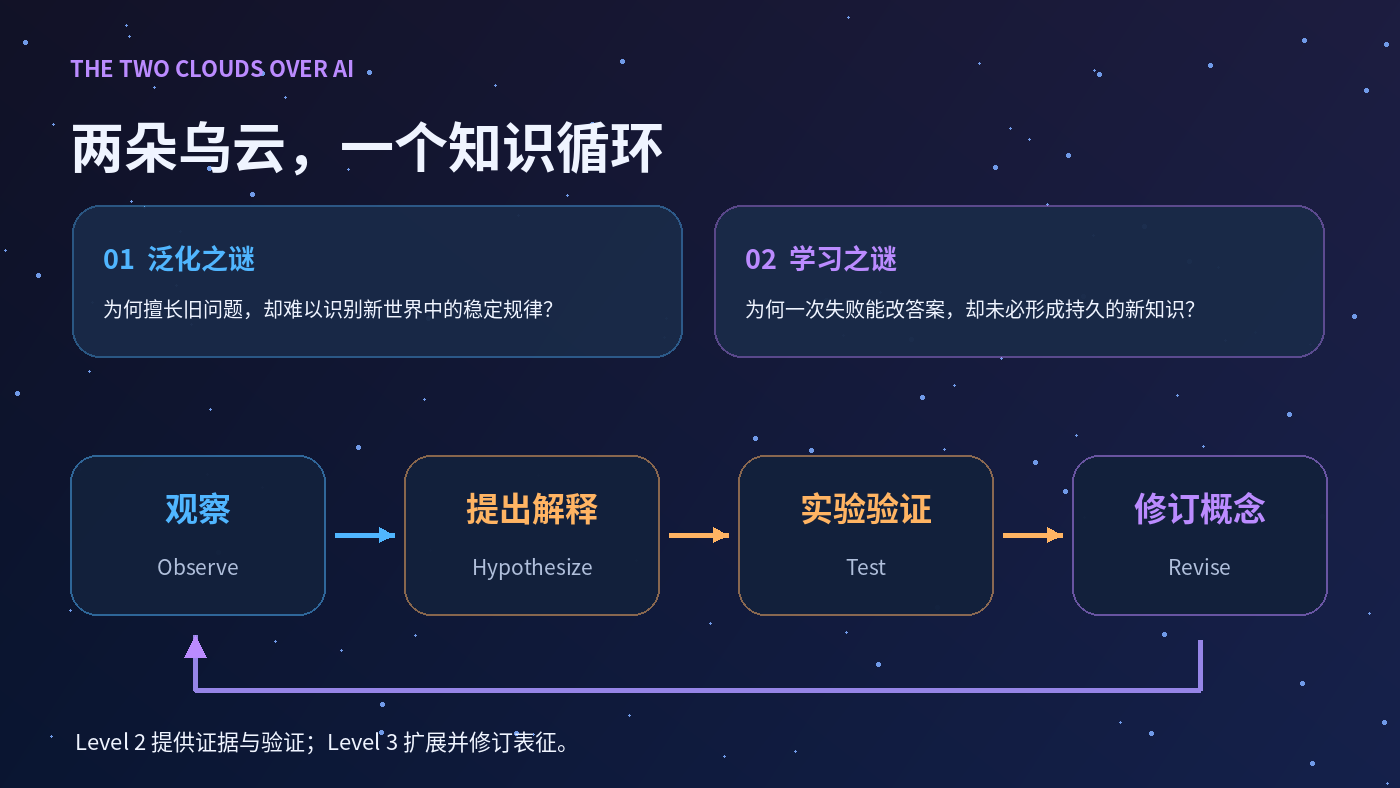
两朵乌云:概念能迁移多远,又能怎样修订
1900 年,开尔文在演讲中把当时物理学尚未解决的两个问题比作“两朵乌云”。一朵关乎以太与物体的相对运动,另一朵关乎能量均分定理。我借用这个比喻来看 AI 的抽象能力。一个概念在原来的任务上好用,接下来还要看它能否迁移到新环境,以及在遇到反例时能否被修订。 [10]
第一朵乌云是泛化。训练阶段可以从很多套表征中挑出一套拟合得足够好的。换一个环境,原先重合的预测开始分开,模型才暴露出自己究竟依赖了什么。如果它保留了任务之间共享的关系,新任务只需要学会少量环境特有的细节;如果它把这些细节也当成规律,每次环境变化都会迫使它重新学习。抽象的价值首先体现在这部分本可避免的重复学习上。 [4]
第二朵乌云是持续学习。一旦迁移失败,系统需要判断失效的是某次推断、某个机制假设,还是多个任务共用的状态表征。修订的位置决定影响范围:改一个参数可以修正局部偏差,拆分一个概念则可能同时改写许多旧预测。系统需要辨认旧知识的适用条件,才知道哪些关系仍然有效、哪些需要修订。
具身智能提供了一个例子。更多同类演示可以让机器人在熟悉场景中做得更好,换了物体或环境后,效果却可能很有限。真机研究发现,扩大环境和物体的多样性更有利于迁移。这让我怀疑,有些看似难以靠扩大规模解决的问题,瓶颈可能出在一开始就选错了学习目标。如果目标是让同一技能适用于不同机器人,模型就需要学会不同动作背后的共同任务关系。 [18] [19]
总结
为什么先有推理,再到溯因和抽象
我把推理 → 溯因 → 抽象看作一个能力上的依赖顺序。推理让一个假设承担检验的风险,因为它能说清楚这个假设成立时应当看到什么。溯因用这些预测选实验,让结果改变几个竞争假设的相对可信度。如果连彼此竞争的假设都在同一类条件下反复预测失败,就有理由进一步检查它们共用的概念是否漏掉了关键区别。抽象改写这些概念,新概念又产生新的解释和预测,回到下一轮推理与实验。
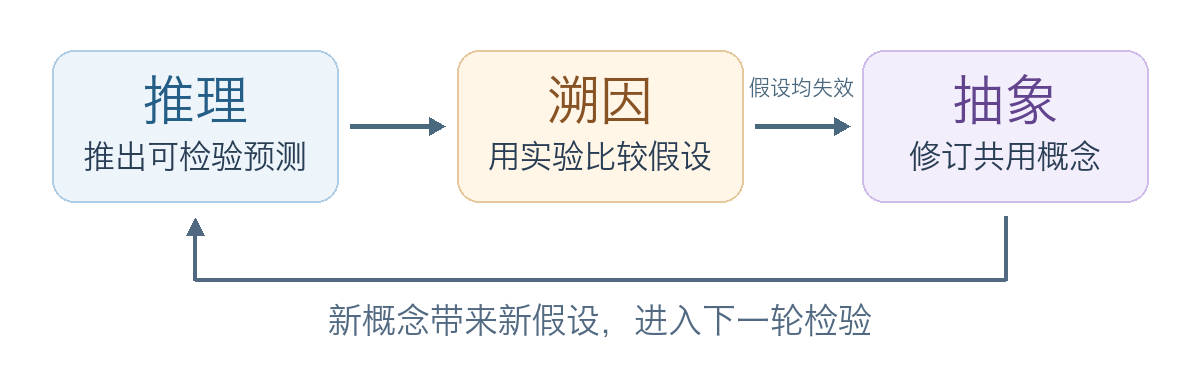
三种能力靠什么取得进展
推理已有一条奏效的扩展路线。 预训练的规模定律(scaling laws)描述了模型、数据和训练算力的规模怎样影响语言模型的预测损失。在这个底座上,可验证奖励的强化学习能改善解题策略,推理时增加计算又能让模型比较更多路径、回溯并检查中间结果。几种机制结合起来,已经在数学和编程等答案可检验的任务上取得了显著进展。 [25] [6] [21]
溯因正在从提出假设走向实验闭环。 这里的核心是环境。实验室、模拟器和可计算的研究系统各自决定了 AI 能做哪些干预、观察到什么,以及以多大成本拿到结果。环境如果能持续给出区分竞争解释的证据,系统就能根据结果修订判断,再选下一次实验。否则,多提出几个假设也只是增加了等待检验的候选。 [11] [17]
抽象还没有一条同样清楚的路线。 我还不知道,什么样的学习过程能让 AI 稳定地发现应该重新定义的概念,以及怎样判断一次修订抓住了可迁移的结构。前面的两朵乌云给出了衡量进展的两个方向。新概念能不能用到未见过的环境?遇到反例后,系统能不能修订它,同时保住已经学到的有效知识?
参考文献与延伸阅读
- Peirce, C. S. (1878). Deduction, Induction, and Hypothesis. Popular Science Monthly, 13, 470–482. — 经典逻辑推理分类的历史来源:演绎、归纳与假设性推理。
- Douven, I. (2011; rev. 2025). Abduction. Stanford Encyclopedia of Philosophy. — 溯因的现代解释及其与其他推理类型的关系。
- Gentner, D. (1983). Structure-Mapping: A Theoretical Framework for Analogy. Cognitive Science, 7(2), 155–170. — 类比中的关系结构映射,为抽象与跨领域迁移提供基础。
- Chollet, F. (2019). On the Measure of Intelligence. arXiv:1911.01547. — 智能、技能获取效率、泛化与 ARC 评测。
- Stanford Encyclopedia of Philosophy (rev. 2022). Scientific Discovery. Stanford Encyclopedia of Philosophy. — 科学发现的哲学研究;包含 selective / creative abduction 的讨论。
- Guo, D., et al. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638. — 以可验证奖励推动数学与代码推理的实证例子。
- Gottweis, J., et al. (2026). Accelerating scientific discovery with Co-Scientist. Nature, 655, 487–496. — AI 科学假设生成、批评与实验验证的案例。
- Rosenthal, R. (1979). The “File Drawer Problem” and Tolerance for Null Results. Psychological Bulletin, 86(3), 638–641. — 选择性发表与负面结果缺失的经典讨论。
- Locatello, F., et al. (2019). Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations. ICML / PMLR, 97, 4114–4124. — 在特定无监督解耦表征设置下,没有归纳偏置就无法保证可识别性。
- Kelvin, Lord (1901; lecture 1900). Nineteenth Century Clouds over the Dynamical Theory of Heat and Light. Philosophical Magazine, 2(7), 1–40. — 本文“两朵乌云”研究视角的历史灵感。
- Lindley, D. V. (1956). On a Measure of the Information Provided by an Experiment. The Annals of Mathematical Statistics, 27(4), 986–1005. — 用信息增益衡量实验价值的经典来源。
- Schölkopf, B., et al. (2021). Toward Causal Representation Learning. Proceedings of the IEEE, 109(5), 612–634. — 从低层观察中发现高层因果变量,与迁移和泛化相关。
- Tishby, N., Pereira, F. C., & Bialek, W. (1999). The Information Bottleneck Method. Allerton Conference on Communication, Control, and Computing. — 保留任务相关信息的压缩表征目标。
- Lu, C., et al. (2024). The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery. arXiv:2408.06292. — 自动化研究流程与科学 Agent 系统的代表性探索。
- OpenAI (2026). The Quasi-Riemann Hypothesis: A Zero-Free Half-Plane Re(s) > 7/8. Lean 形式化的命题与范围.
- Baker, M. (2026). Some early morning thoughts on the OpenAI dump. 文中记录了 Alex Kontorovich 对准黎曼猜想成果的评价。
- Jagadish, A. K., et al. (2026). Closing the Loop to Discover Psychological Theories with an Automated Cognitive Scientist. arXiv:2606.26448.
- Lin, F., et al. (2024, rev. 2026). Data Scaling Laws in Imitation Learning for Robotic Manipulation. arXiv:2410.18647.
- Physical Intelligence (2025). π₀.₅: a VLA with Open-World Generalization.
- Trinh, T. H., et al. (2024). Solving olympiad geometry without human demonstrations. Nature.
- OpenAI (2024). Learning to reason with LLMs.
- Aristotle. Prior Analytics, Book I. — 《前分析篇》对前提与演绎的讨论。
- Locke, J. (1690). An Essay Concerning Human Understanding, Book II, Chapter XI, §9. — 从个别经验形成一般观念的讨论。
- Zahavy, T. (2026). Position: LLMs can’t jump. Proceedings of the 43rd International Conference on Machine Learning. — 运用演绎、归纳与溯因的区分来讨论 AI 科学发现。
- Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361. — 语言模型预测损失与模型、数据和训练算力规模之间的经验关系。